AI+医学编码:告别手工低效,易迪希邀您迈入智能编码新时代


在药物研发、临床试验与真实世界研究等高价值、强监管领域,海量且非结构化的医疗文本数据(如不良反应报告、患者描述)的标准化编码是实现“数据驱动决策”的核心基石。
然而,当前实现标准化编码的路径仍存在诸多局限。传统人工编码模式效率低下、编码标准一致性难以保障且人力成本高昂;而时下主流的AI解决思路——直接调用大语言模型(LLM)生成编码,虽看似便捷,但在严肃医疗场景中,却面临数据安全风险、合规成本攀升、可解释性不足,甚至产生“幻觉”编码等一系列痛点。
针对现有编码方案的各类缺陷,易迪希创新性地提出一套全新的技术架构与实践范式,旨在构建一个更安全、更精准、更合规的智能编码推荐系统,重新定义该领域的工作模式。
全链路技术实现:从数据到持续进化
传统“LLM直接生成模式”本质上是一种无约束的开放生成范式。在这种模式下,系统将描述文本直接提交给LLM,指令其“凭空”输出对应的标准编码。这种方式的根本缺陷在于:LLM的知识完全源自训练语料,完整性与实时性均无法精确保证,且普遍存在输出“幻觉”编码(捏造虚假、过时或不存在的编码)的风险。
相比之下,本方案所倡导的“检索增强+智能精排模式”则是一种检索增强、约束性极强的分类/排序范式。系统不依赖LLM生成新知识,而是强制其在经严格审查的知识库中进行优化选择。
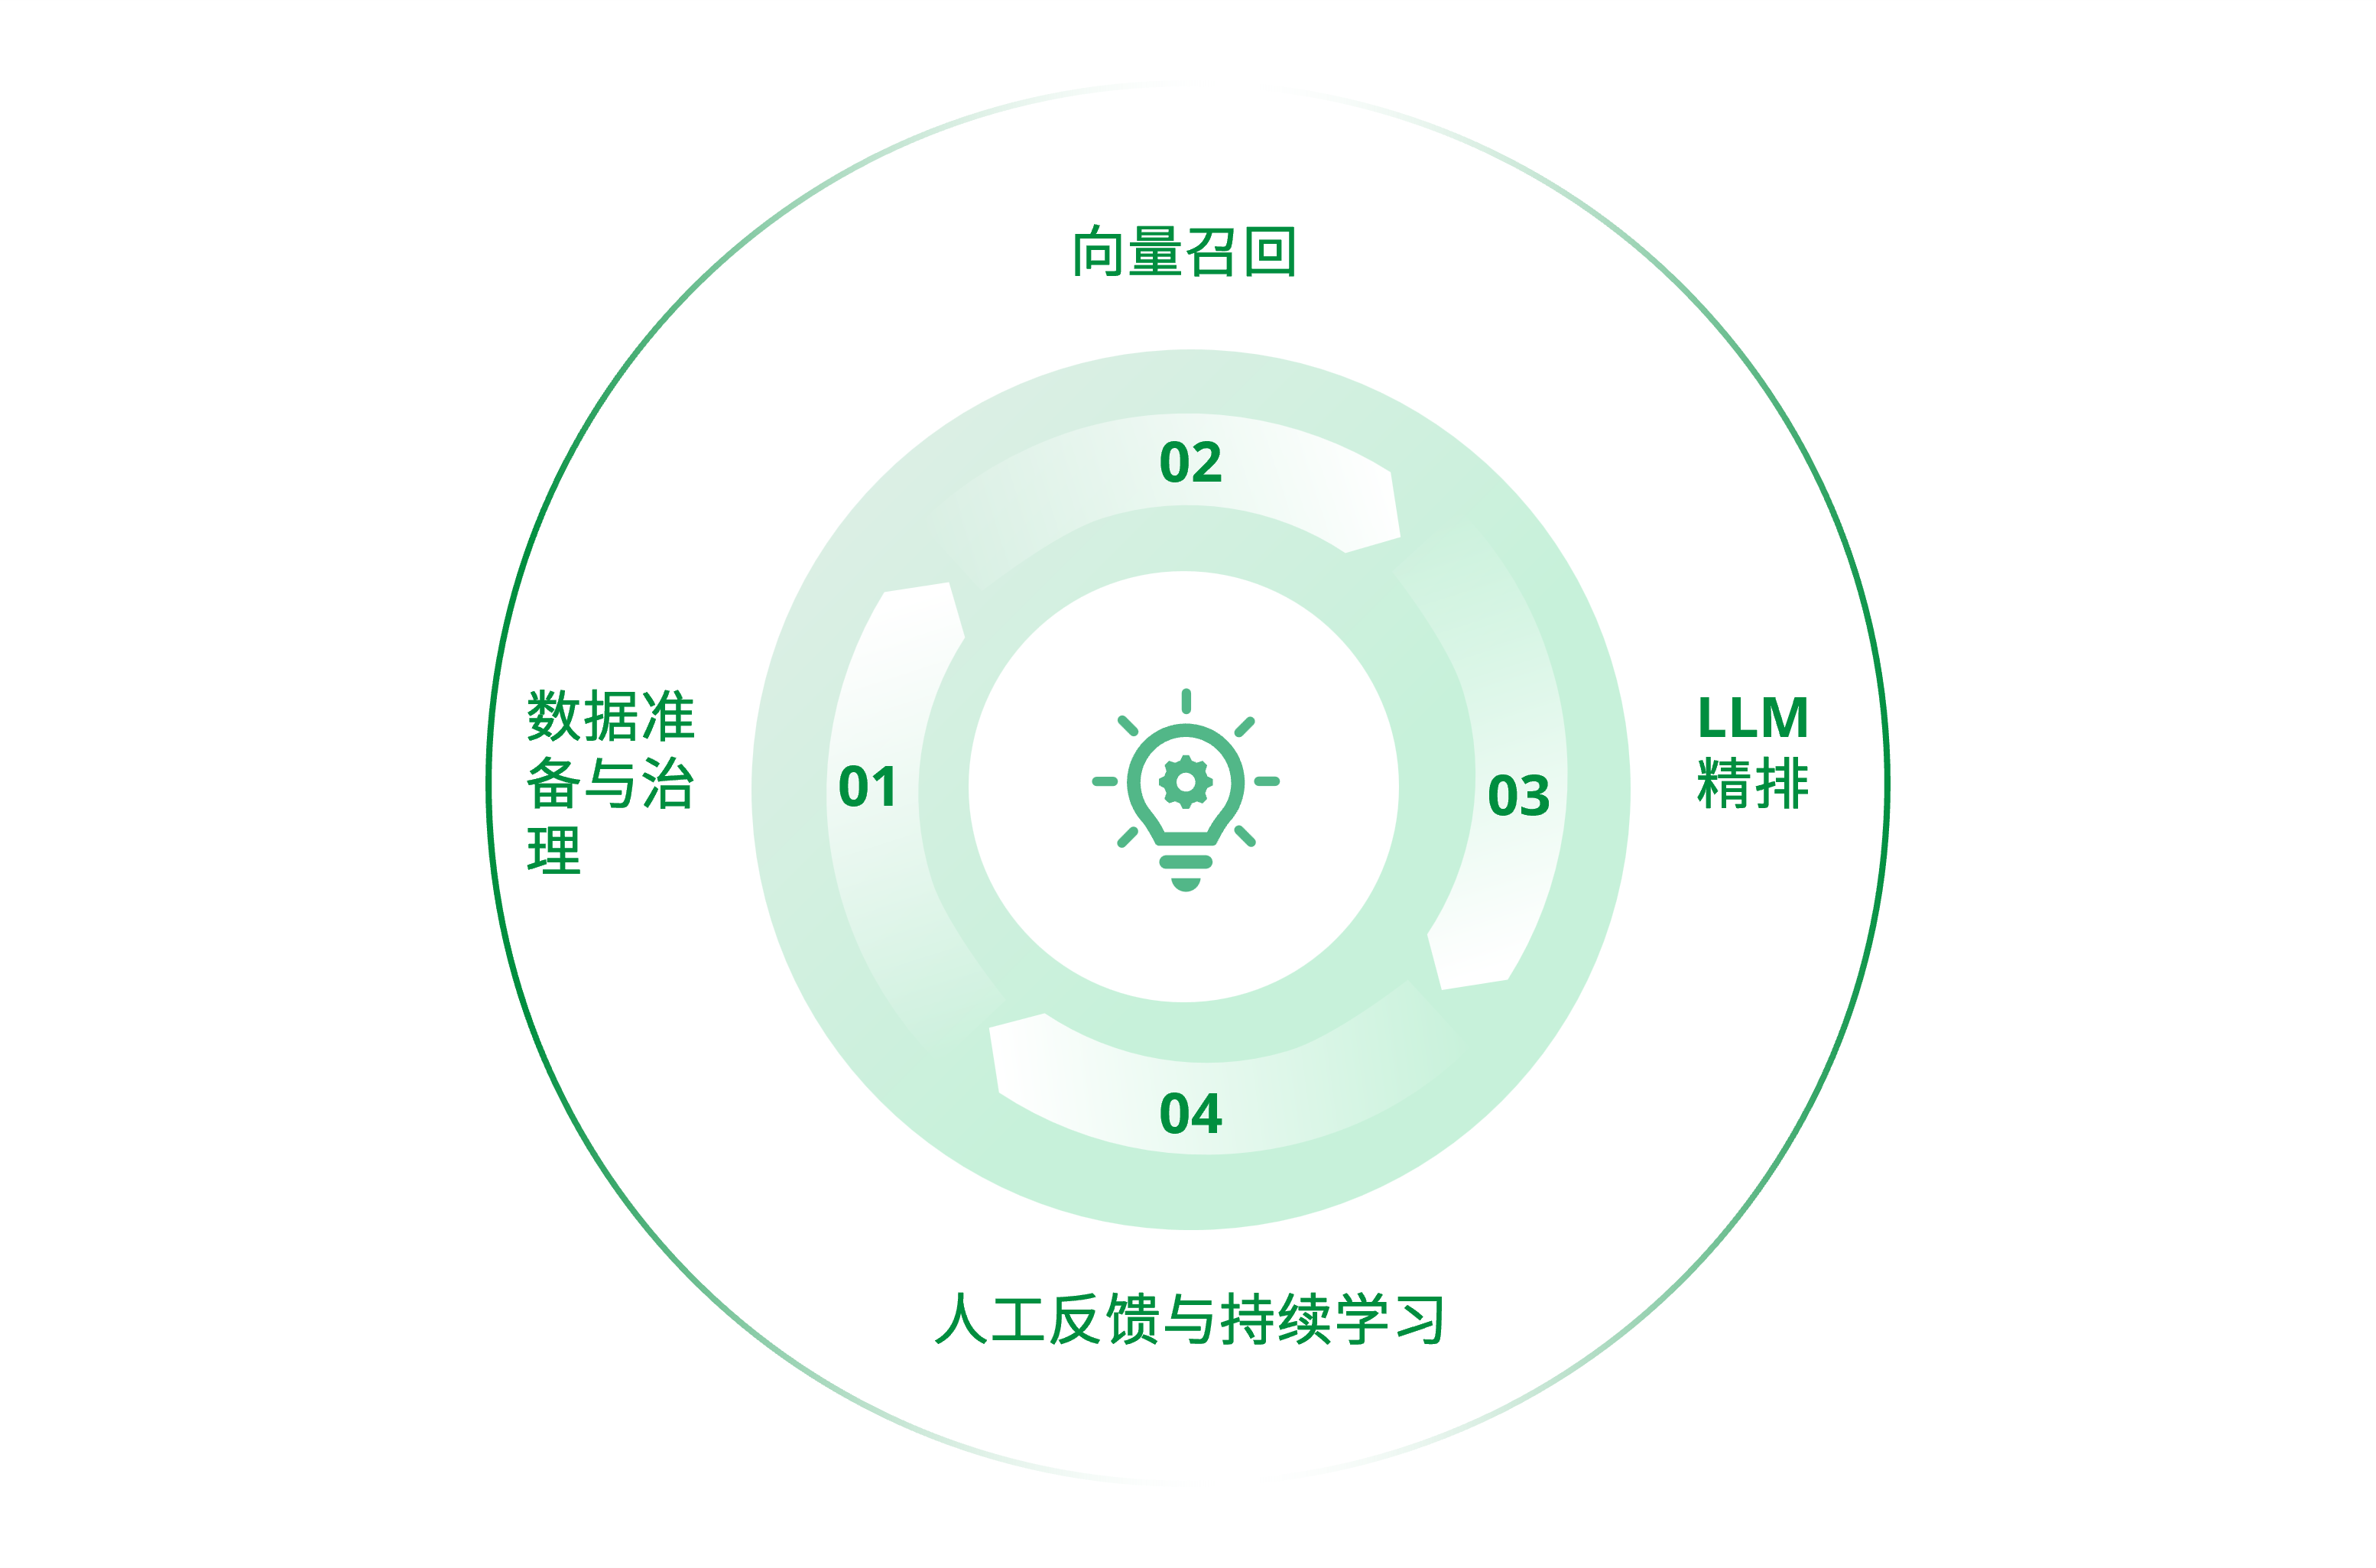
这套系统的核心架构,可以概括为RAG架构下的“数据—召回—精排—进化”全链路闭环:
01 数据准备与治理--智能基石
系统整合了权威医学辞典、专家校验的历史编码库、同义词与缩写映射、客户自定义规则四大数据源,经脱敏、规范化、去重及数据增强(含困难负样本挖掘),构建出能精准应对各类不规范、口语化描述的复合训练数据集。
02 向量召回(粗排)--高效雷达 系统采用多语言微调模型(如microsoft/Multilingual-MiniLM)与双塔架构,对术语库进行离线预计算和向量化,配合PostgreSQL+pgvector实现毫秒级语义检索。
经过调优,系统向量召回模型能够实现极高的命中率——在召回的前5个候选中覆盖98.1%的正确编码。这保证了正确答案几乎一定会进入候选池,为后续精排的成功奠定了决定性基础。
03 LLM精排 -- 专家裁决
这一步是系统决策的核心。LLM的任务被严格限定为“在给定范围内选择最佳答案”,而非“创造答案”。系统将用户原始描述、全部召回候选术语(含术语详情、层级关系、向量相似度分数等)构建为提示词上下文,交由私有化部署的LLM进行深度比对与排序推理。
最终,LLM会输出带置信度、附简明理由说明的排序推荐列表。前3个候选(Recall@3)准确率达97.3% ,决策过程透明、可解释、可审计,契合GxP对数据完整性与可追溯性的严格要求。
04 人工反馈与持续学习闭环--进化引擎
不同于一次性部署的静态系统,易迪希AI医学编码解决方案构建了强大的在线学习与持续优化闭环。系统会记录并分析编码人员的每一次采纳、修改、标注行为——这些宝贵的“人机交互”数据会被自动回传,用于持续优化向量召回模型、丰富同义词库、提升模型对相似术语的区分能力。
这意味着,系统部署得越久、使用越频繁,对特定机构、特定治疗领域的适应性和准确性就越高。它不再只是一个工具,而是一个能随业务共同成长的“智能资产”。
举个例子
以一个具体业务场景为例:待编码报告术语为 “吗啡注射液”,采用编码字典版本为 WHODrug GLOBAL(B3)-C[V2022MAR]。
若直接通过通用大语言模型执行编码,输出推荐结果首位为“MORPHINE INJECTION”,“吗啡”位列次位。
而经易迪希自研AI医学编码方案处理后,“吗啡”被排序至第一位,排序结果更贴合实际医学使用偏好。
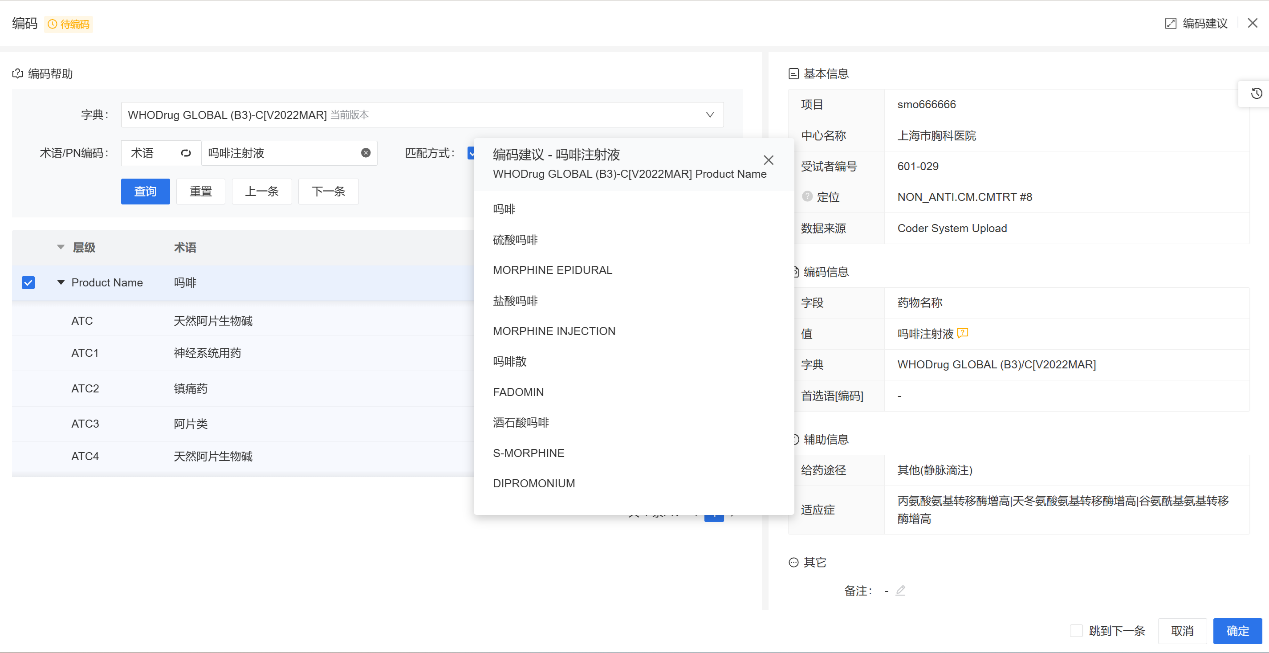 易迪希智能编码建议
对比一目了然: 为什么“约束选择”比“开放生成”更靠谱?
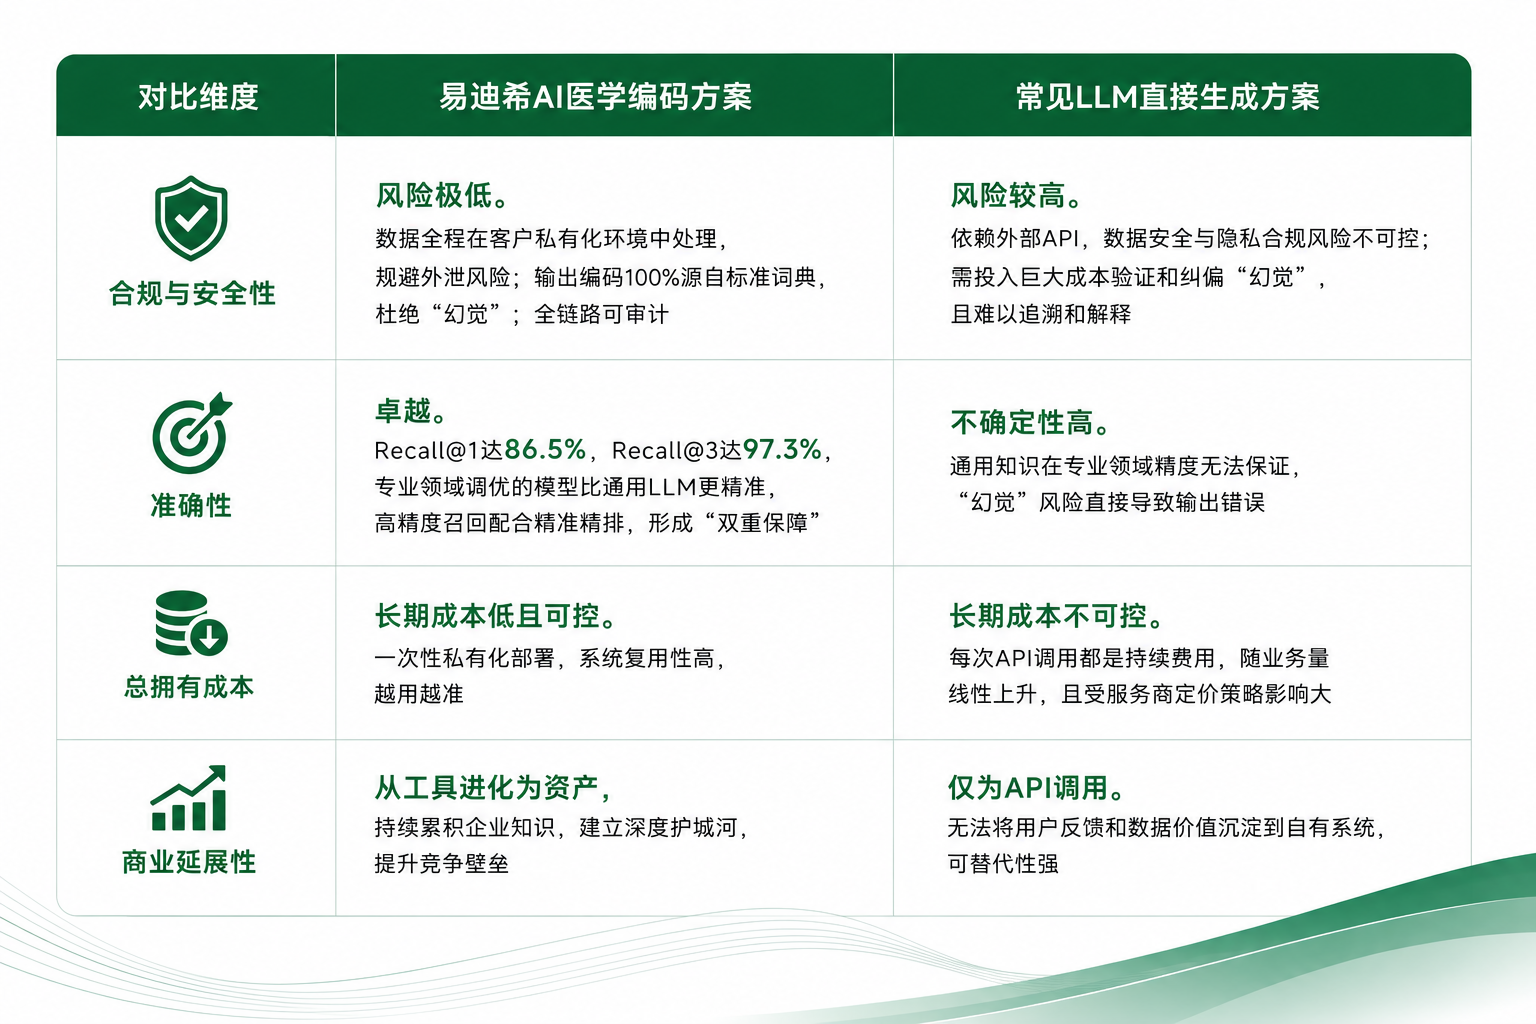
对于医药研发而言,效率提升绝不能以合规风险为代价——易迪希智能编码解决方案,正是基于这一原则设计研发。系统提供的不只是一个编码工具,而是一个整合了医学专业知识、可控AI技术与企业私域数据的自动化、智能化、可进化的整体解决方案,可为临床试验数据管理流程带来持续的效率跃升。
易迪希诚邀您,与我们一同迈入医学编码的智能时代,在合规的框架内释放AI效能,让编码的每一秒提速,都化作加速新药上市的关键动力。
更多信息,欢迎咨询: bd@clinflash.com
 上一页
 首页
 下一页