易迪希前沿研究成果亮相PharmaSUG 2026,AI轻量化方案智赋临研!


近日,易迪希统计团队在PharmaSUG 2026上发表技术论文《Automated Clinical Text Classification with Robust Machine Learning for Pharmaceutical Data Curation》,创新性地提出了一种基于轻量级机器学习模型的临床试验图表数据集自动标注方法,为统计编程工作流中的标注环节提供了更加高效、准确、且可一键部署的自动化解决方案。
在临床试验统计编程中,每一份图表目录(TOC)文件都需要为图表标题匹配对应的CDISC ADaM数据集标签(如ADSL、ADAE、ADLB)。长期以来,这项工作高度依赖SAS程序员逐一判断,一个典型研究需耗时30至60分钟,此外,不同程序员对同一标题的理解时有分歧,导致标注结果难以完全统一。当并行研究数量增至数十个时,这类重复劳动往往成为拖累统计编程整体效率的隐形瓶颈。
面对效率与一致性的双重要求,易迪希统计团队从业务实际出发,提出了一条更轻量、更可控的技术路径。
两步式智能标注:从模型训练到一键产出
依托14项完整临床研究、1849条真实标注数据(涵盖60个CDISC数据集标签),易迪希统计团队设计了一个基于TF-IDF文本向量化+逻辑回归分类的轻量级机器学习模型。模型通过学习图表标题与CDISC数据集标签之间的对应规律,能够自动为新图表匹配最合适的ADaM数据集。
整个运作流程分为两步:
1 训练阶段
模型从历史TOC文件中提取图表的TITLE(标题)和人工标注的DATASET(数据集标签)作为训练样本。通过TF-IDF算法将中文图表标题转化为数值特征向量,再交由逻辑回归分类器学习标题文本与数据集标签之间的映射关系。整个过程在标准笔记本CPU上耗时不到2秒。
2 预测阶段
当用户传入一份新的、尚未标注的TOC文件时,模型将自动识别每一条图表标题,依据训练阶段学到的规律,预测出最匹配的CDISC数据集标签,并填入对应位置。一份包含上百张图表的新文件,预测几乎可以瞬时完成。
更关键的是,整个工具被封装为一个无需安装任何Python环境、双击即可运行的Windows独立程序(.exe)。用户无需深入掌握任何编程或机器学习知识,只需选择待处理的TOC文件,程序便会自动完成预测,并生成一份带有标注结果的Excel文件,供统计程序员快速复核。
AI 赋能,让统计工作回归核心研发
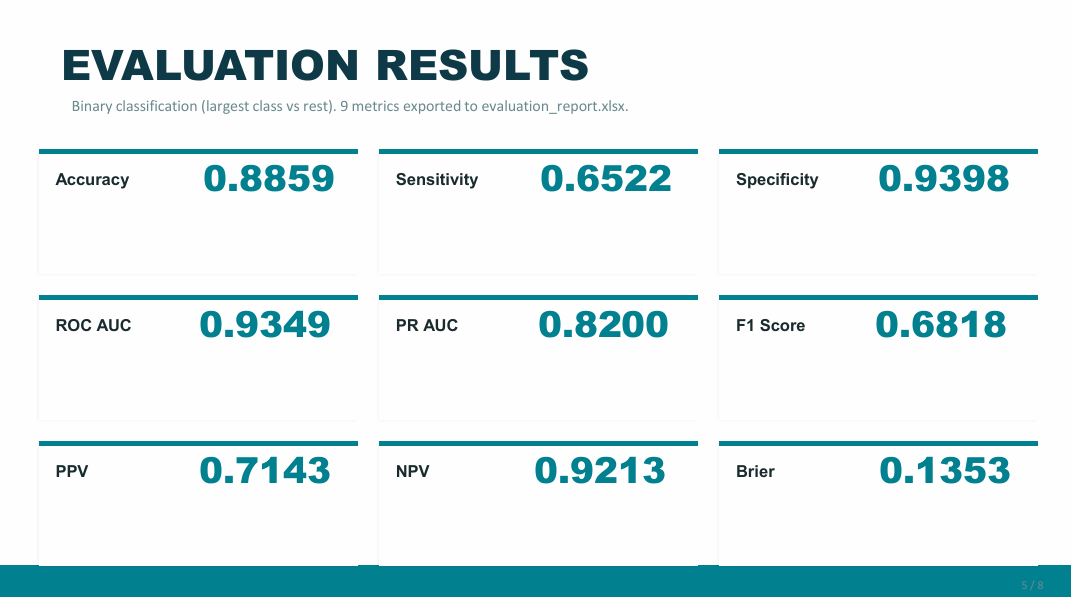
为全面检验这套方案的可靠性,易迪希统计团队在二分类评估框架下对工具进行了系统验证,重点考察模型在实际业务场景中产生误标的风险。结果表明,该工具投入日常统计编程工作流后性能表现十分稳健:
整体预测准确率88.59%,全局标注错误率可控;
ROC-AUC达0.934,模型区分不同 CDISC 数据集的能力突出;
特异度93.98%,大幅降低将安全性数据集(ADAE、ADLB)错判的风险,规避递交隐患;
PR-AUC为0.820,针对样本不均衡的临床标签场景依然保持稳定识别效果。
部署应用该工具后,录入工作可从时效、标准、人力三大维度实现全面升级:
效率颠覆:单项目TOC标注时间从30-60分钟缩短至不到10秒,释放统计编程团队人力,聚焦数据审核与高价值分析;
标准统一:模型给出确定性标注结果,规避跨人员、跨项目标注不一致的问题,提升数据标准化程度;
低门槛落地:轻量化架构无额外运维成本,无缝对接现有CDISC交付SOP,真正做到“让技术适应人”。
作为易迪希在AI驱动临床研发领域的又一前沿学术成果,该方案不仅系统验证了轻量级机器学习方法在临床数据标注场景中的可行性与可靠性,还将为公司后续拓展更多自动化AI技术应用筑牢实践基础,以高效、可审计的智能技术持续简化CDISC标准化交付流程。
未来,易迪希将持续深耕AI在临床研究领域的应用探索,积极参与行业交流,以更多兼具创新性与实用性的前沿技术探索与实践,助力各类临床试验高效推进,赋能生物医药行业高质量发展。
 上一页
 首页
 下一页