易迪希前沿研究成果亮相PharmaSUG 2026,AI輕量化方案智賦臨研!


近日,易迪希統計團隊在PharmaSUG 2026上發表技術論文《Automated Clinical Text Classification with Robust Machine Learning for Pharmaceutical Data Curation》,創新性地提出了一種基於輕量級機器學習模型的臨床試驗圖表數據集自動標註方法,為統計編程工作流中的標註環節提供了更加高效、準確、且可一鍵部署的自動化解決方案。
在臨床試驗統計編程中,每一份圖表目錄(TOC)文件都需要為圖表標題匹配對應的CDISC ADaM數據集標籤(如ADSL、ADAE、ADLB)。長期以來,這項工作高度依賴SAS程序員逐一判斷,一個典型研究需耗時30至60分鐘,此外,不同程序員對同一標題的理解時有分歧,導致標註結果難以完全統一。當並行研究數量增至數十個時,這類重複勞動往往成為拖累統計編程整體效率的隱形瓶頸。
面對效率與一致性的雙重要求,易迪希統計團隊從業務實際出發,提出了一條更輕量、更可控的技術路徑。兩步式智能標註:從模型訓練到一鍵產出
依託14項完整臨床研究、1849條真實標註數據(涵蓋60個CDISC數據集標籤),易迪希統計團隊設計了一個基於TF-IDF文本向量化+邏輯回歸分類的輕量級機器學習模型。模型通過學習圖表標題與CDISC數據集標籤之間的對應規律,能夠自動為新圖表匹配最合適的ADaM數據集。
整個運作流程分為兩步:
1. 訓練階段
模型從歷史TOC文件中提取圖表的TITLE(標題)和人工標註的DATASET(數據集標籤)作為訓練樣本。通過TF-IDF算法將中文圖表標題轉化為數值特徵向量,再交由邏輯回歸分類器學習標題文本與數據集標籤之間的映射關係。整個過程在標準筆記本CPU上耗時不到2秒。
2. 預測階段
當用戶傳入一份新的、尚未標註的TOC文件時,模型將自動識別每一條圖表標題,依據訓練階段學到的規律,預測出最匹配的CDISC數據集標籤,並填入對應位置。一份包含上百張圖表的新文件,預測幾乎可以瞬時完成。
更關鍵的是,整個工具被封裝為一個無需安裝任何Python環境、雙擊即可運行的Windows獨立程序(.exe)。用戶無需深入掌握任何編程或機器學習知識,只需選擇待處理的TOC文件,程序便會自動完成預測,並生成一份帶有標註結果的Excel文件,供統計程序員快速複核。
AI 賦能,讓統計工作回歸核心研發
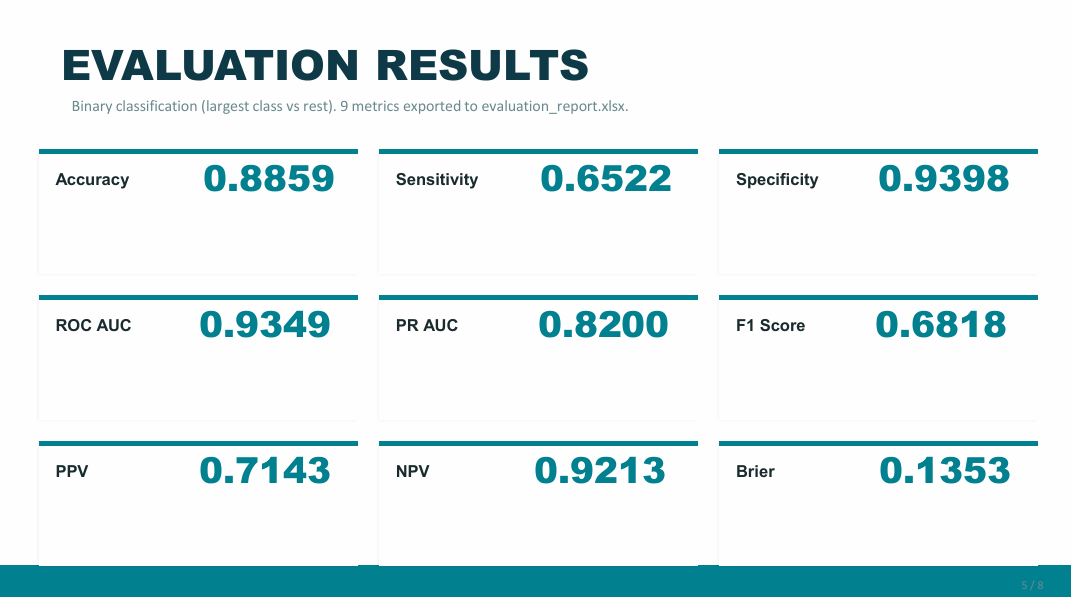
為全面檢驗這套方案的可靠性,易迪希統計團隊在二分類評估框架下對工具進行了系統驗證,重點考察模型在實際業務場景中產生誤標的風險。結果表明,該工具投入日常統計編程工作流後性能表現十分穩健:
整體預測準確率88.59%,全局標註錯誤率可控;
ROC-AUC達0.934,模型區分不同 CDISC 數據集的能力突出;
特異度93.98%,大幅降低將安全性數據集(ADAE、ADLB)錯判的風險,規避遞交隱患;
PR-AUC為0.820,針對樣本不均衡的臨床標籤場景依然保持穩定識別效果。
部署應用該工具後,錄入工作可從時效、標準、人力三大維度實現全面升級:
效率顛覆:單項目TOC標註時間從30-60分鐘縮短至不到10秒,釋放統計編程團隊人力,聚焦數據審核與高價值分析;
標準統一:模型給出確定性標註結果,規避跨人員、跨項目標註不一致的問題,提升數據標準化程度;
低門檻落地:輕量化架構無額外運維成本,無縫對接現有CDISC交付SOP,真正做到「讓技術適應人」。
作為易迪希在AI驅動臨床研發領域的又一前沿學術成果,該方案不僅系統驗證了輕量級機器學習方法在臨床數據標註場景中的可行性與可靠性,還將為公司後續拓展更多自動化AI技術應用築牢實踐基礎,以高效、可審計的智能技術持續簡化CDISC標準化交付流程。
未來,易迪希將持續深耕AI在臨床研究領域的應用探索,積極參與行業交流,以更多兼具創新性與實用性的前沿技術探索與實踐,助力各類臨床試驗高效推進,賦能生物醫藥行業高質量發展。
 上一頁
 首页
 下一頁